
实验室搞科研改代码,它能帮你搭个专属AI管家
说实话,在实验室做课题或者赶课程大作业,最头疼的就是两件事:一是找AI改论文改代码时,网速动不动卡住,要么账号突然被封;二是导师反复强调过,未发表的实验数据、测序结果和核心代码,千万不能随便传到外面的公共网站上去,万一被拿去训练或者泄露了,毕业论文直接完蛋。
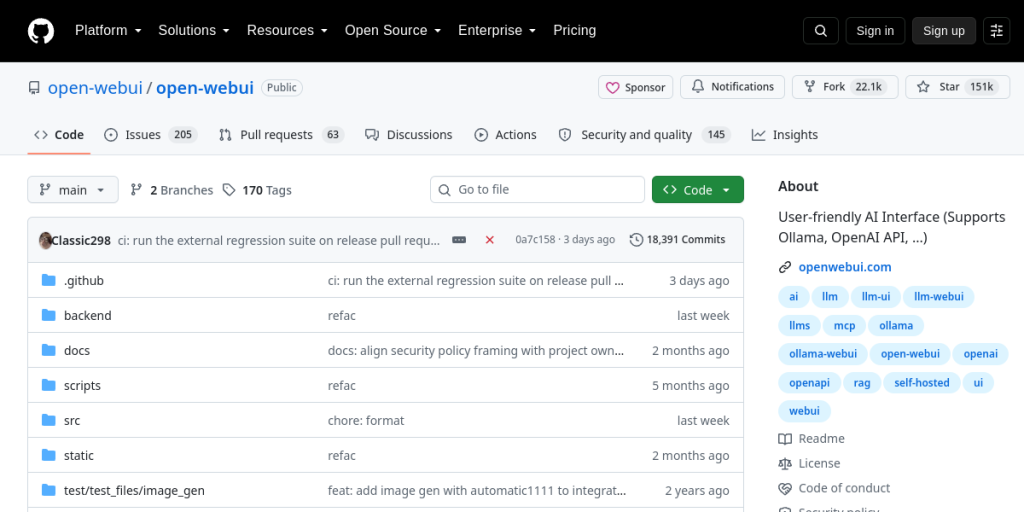
Open WebUI解决的就是这个痛点。它本质上是一个部署在你自己电脑或者实验室服务器上的私有网页端,界面布局和操作习惯跟咱们平时用的ChatGPT几乎没有差别,左边是历史会话,中间是对话框,支持夜间模式,排版看着特别舒服。
平时写Python或者跑仿真遇到一堆报错,直接把几百行红字贴进去让它查,或者把开题报告的初稿发给它改改病句,反应很快。最紧要的是,如果你的电脑连着本地离线跑的大模型,就算你把网线拔了、断开Wi-Fi,它依然能正常跟你聊天。所有问答记录全保存在你自己的本地硬盘里,没有任何人能偷看你的数据,写核心论文或者处理保密项目时,用它心里是真踏实。
师姐手把手教你三招,把这套界面用到极致
很多学弟学妹刚听说这个工具时,觉得搭环境特别高深,其实掌握好这几招,平时用起来真的省心:
第一招,用容器工具一行命令搞定,千万别去折腾复杂的源码编译。电脑里先装好Docker Desktop,在终端里直接复制官方那行最基础的运行命令,几分钟就把整个网页服务跑起来了。后台再装一个叫Ollama的小程序,去下载个几个G大小的小模型。宿舍台式机只要显卡稍微过得去,本地改句子、查语法毛病立刻就能开工,省去天天找镜像节点的烦恼。
第二招,善用它的知识库功能去啃英文长文献。平时搞大作业或者写文献综述,导师甩过来五六篇几十页的英文PDF,自己逐字逐句读能把人看哭。你可以在它的文档管理里新建一个集合,把这几篇PDF拖进去建个小知识库。提问时在输入框输入对应标签,直接问它“第三篇论文用了哪种算法”、“这几篇文章在实验对比上有什么异同”。它会先在文档里划重点,再总结答案,比你自己按Ctrl+F全篇搜关键词能省大把时间。
第三招,拉上寝室室友或者同组同门搞“拼单共建”。如果你手头只有轻薄本,可以找实验室有带独显台式机的师兄,把Open WebUI挂在那台公用机器上,开启局域网共享。大家注册各自的账号,聊天记录互相完全看不到。再去国内正规平台买个几块钱的便宜大模型接口填进去,几个人一起分摊,每天疯狂问代码、润色英文摘要,一个学期下来每个人摊不到一瓶奶茶钱,用着还跟正版会员一样顺畅,省钱又省事。
别高兴太早,这几个技术硬伤真能把人折腾哭
虽然这玩意儿吹得挺好,但作为踩过坑的老学长,我必须无情揭短,这几个坑千万别踩:
第一,它只是个长得漂亮的空壳子,本身脑子里一滴墨水都没有!很多新手装完之后,一打开网页发现根本没法说话,急得在群里到处问。它必须依赖后台连接的大模型引擎。如果你用的是轻薄本,既没有独立显卡,也没配置外部接口,硬要在本地跑模型,电脑风扇会直接起飞狂转,烫得能煎鸡蛋,而且AI打字一个字一个字往外蹦,速度慢到让你怀疑人生,算数学题或者改长文章直接卡死。
第二,网络和环境配置真挺折腾人。校园网环境特别复杂,有时候镜像下载到一半就断连报错,或者内网端口冲突打不开网页。对计算机底子薄的同学来说,光是解决终端报错就能耗掉一整天时间,大作业还没开始写,心态先崩了。
第三,本地知识库读图表容易“胡说八道”。别太迷信它读PDF的能力!如果论文里有双栏排版、复杂的分数公式,或者跨页的大表格,它抓取文字时经常会断行、漏字,直接把公式变成乱码。AI在断章取义的情况下,很容易一本正经地编造数据。千万别把它的文献总结直接复制进开题报告,万一引文结论是瞎编的,拿去开题答辩被老师当场揪出来,真能让你当场社死。
大实话劝退指南,到底谁适合折腾谁赶紧绕道
最后掏心窝子给大家画个分水岭,别盲目跟风折腾:
如果你是工科生、计算机相关专业,或者手头有台带独立显卡的主机、实验室公用服务器,平时对数据隐私要求高,极度讨厌用公共AI时动不动封号、断网,那我强烈建议你花一个下午把它搭起来。这套东西搭好之后,用起来就像自己专属的工作台,文献管理、代码调试随叫随到,绝对是搞科研的得力帮手。